Speech recognition & audio understanding
Qwen-Audio-3.1-ASR
Multilingual speech recognition with non-streaming speaker diarization in Flash and Next, plus general audio understanding in Next.
30 languages16 Chinese dialects
 Qwen Audio
Alibaba · Speech & audio research
From listening and understanding to speaking and creating. Explore the Qwen-Audio series and our wider family of speech and audio projects.
Speech recognition & audio understanding
Multilingual speech recognition with non-streaming speaker diarization in Flash and Next, plus general audio understanding in Next.
Real-time voice interaction
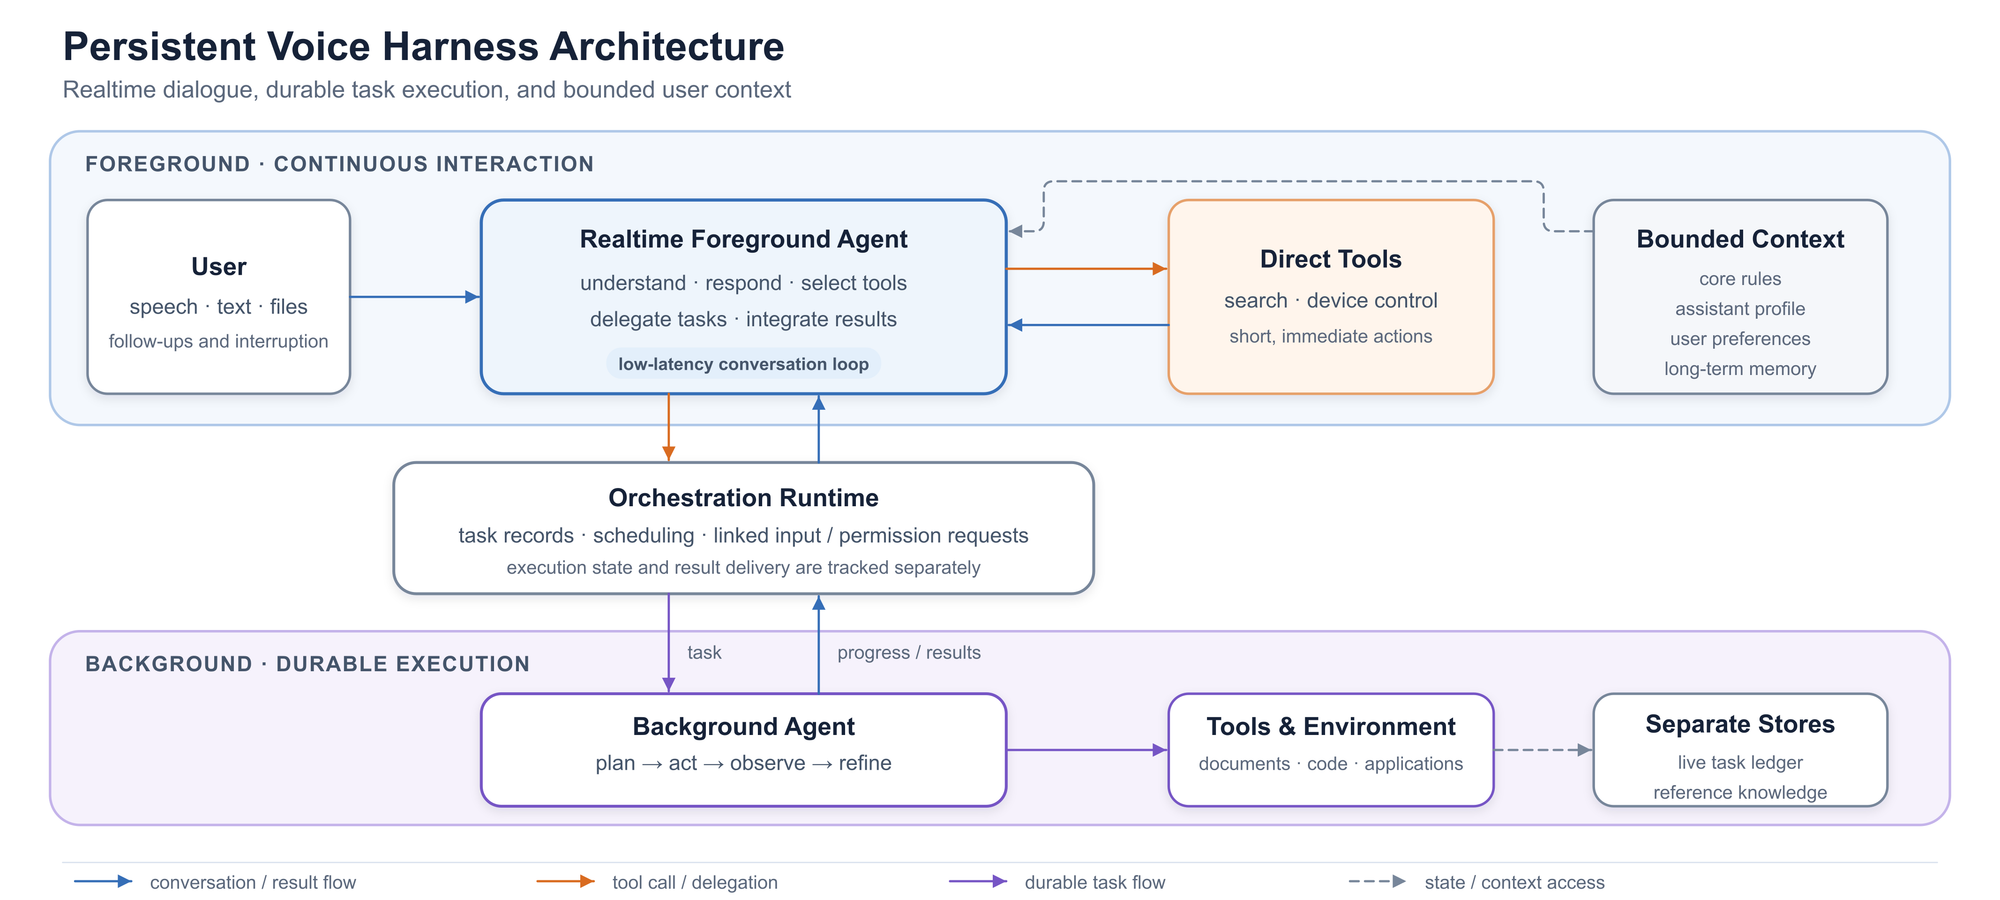
Explore spoken reasoning, tool use and natural interaction, alongside a persistent voice agent built as a separate runtime extension.
Speech recognition · 3.0
Multilingual and dialect recognition with streaming transcription, contextual recognition and hotwords.
Speech synthesis · 3.0
Controllable speech synthesis, cross-lingual voice cloning and long-form generation.
Speech recognition
Speech recognition for multilingual, dialect and domain-specific audio.
Speech synthesis
Explore the next generation of multilingual speech generation and voice cloning.
Voice conversation
Connect audio understanding and natural spoken interaction.
Speech synthesis
Streaming synthesis, zero-shot voice cloning and multilingual generation.
Spoken interaction
Multimodal language models for real-time, natural voice conversation.
Music generation
Explore music generation, continuation and music creation examples.
FunAudioLLM · Understanding & generation
The original FunAudioLLM project: multilingual speech understanding, emotion and event recognition, voice generation and voice interaction demos.
Explore inference, serving and application integration with FunASR. See each project for model availability and licensing.